Genel bakış ve Node'lar
İki ekran da yalnızca yöneticiler içindir ve salt okumadır. Üst barda seçili cluster'ı gösterirler.
Genel bakış
Yapmak istediğiniz: cluster'ın sağlıklı olup olmadığını on saniyede görmek. Yöneticiler girişten sonra buraya
gelir; her yerden g o ile açılır.
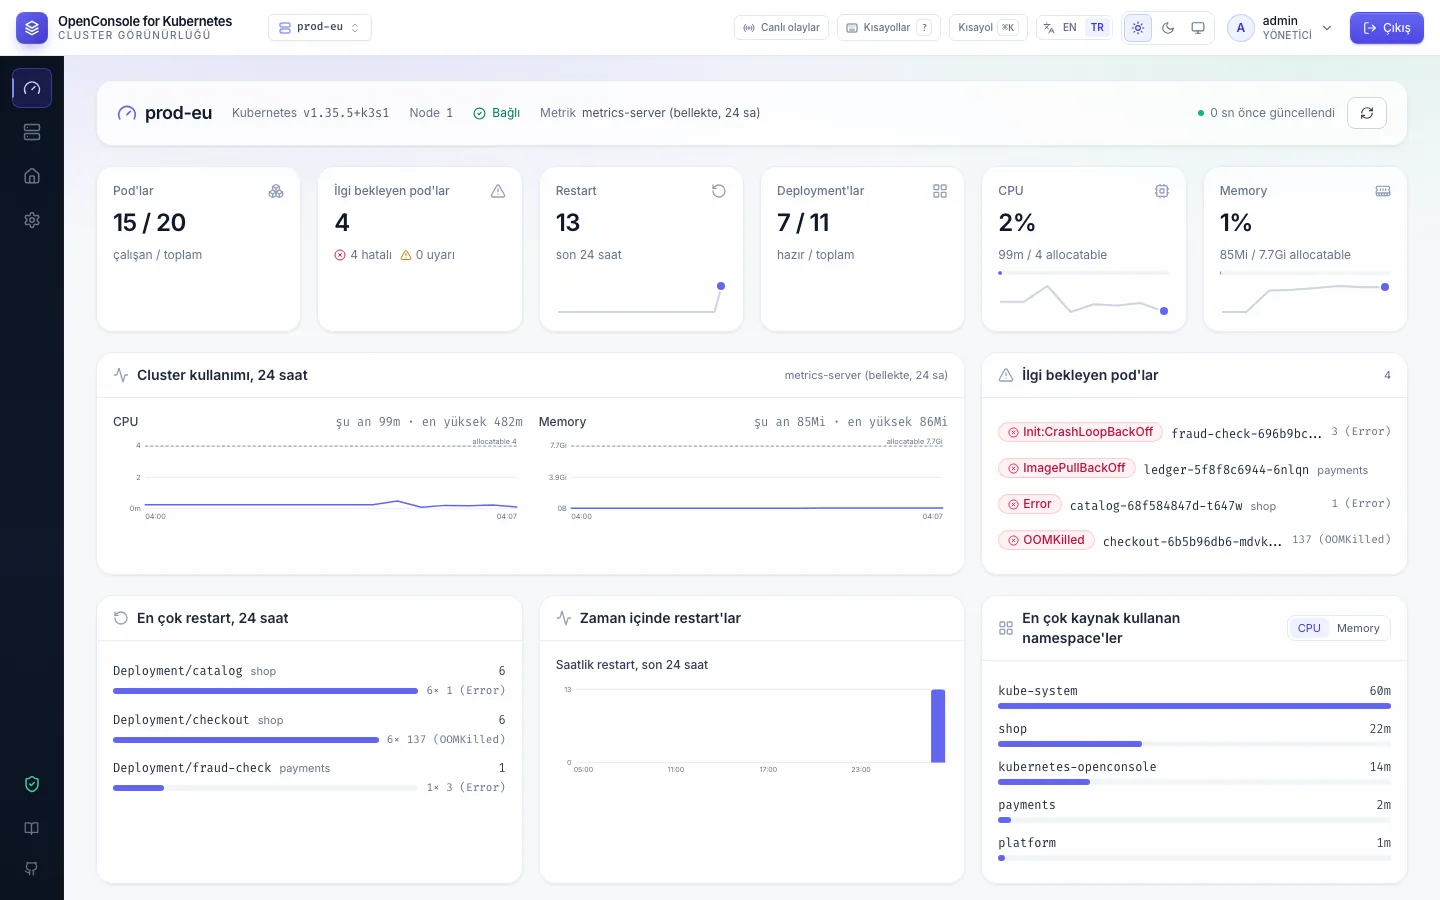
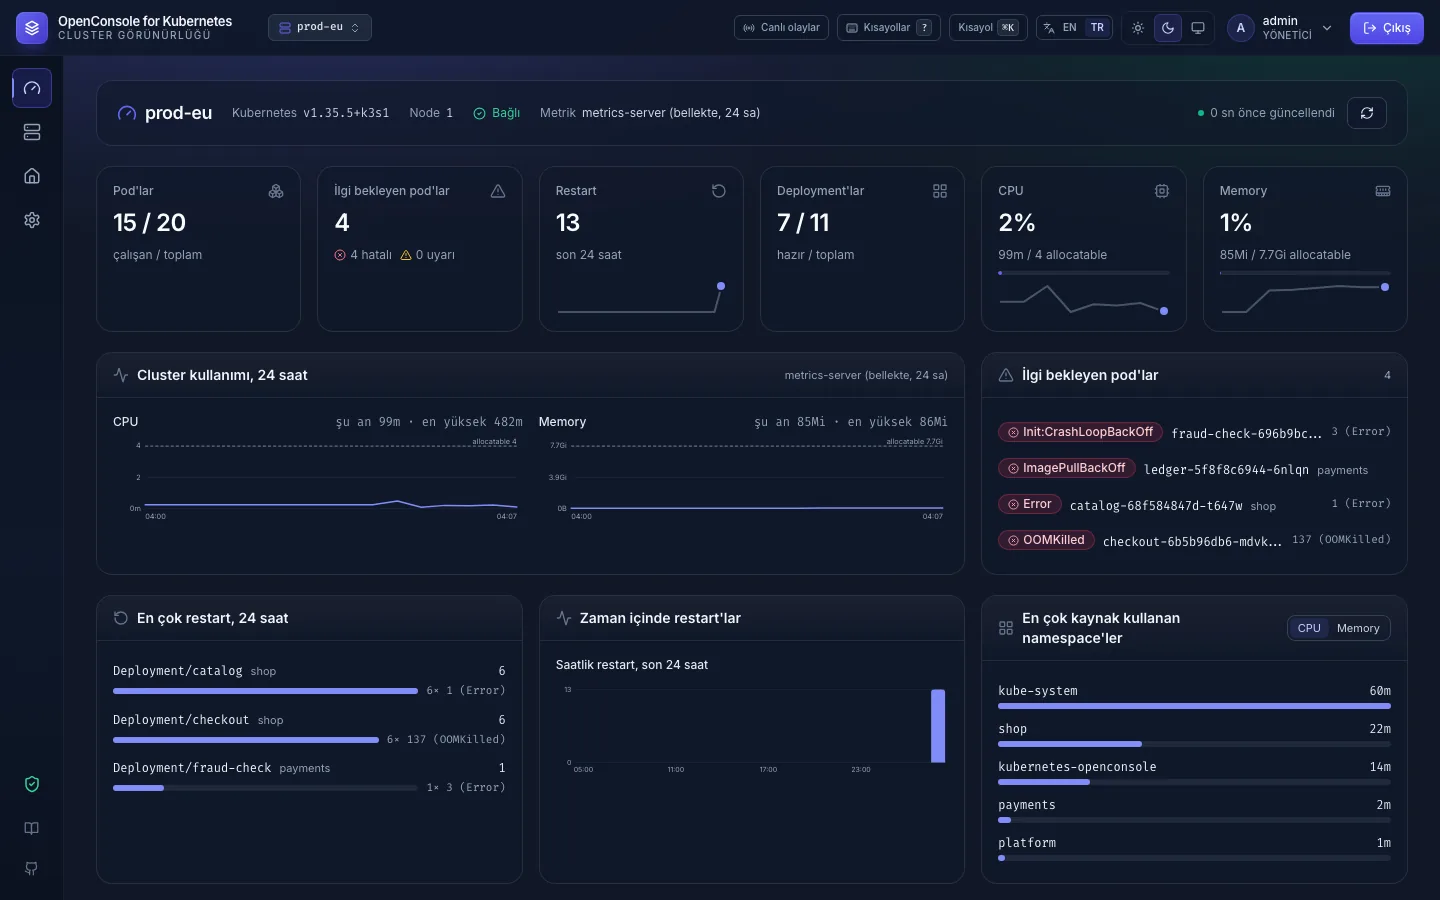
- Kutucuklar: çalışan pod'lar, ilgi bekleyen pod'lar (hatalı / uyarı), son 24 saatteki restart'lar, hazır Deployment'lar, allocatable'ın yüzdesi olarak CPU ve memory; her biri 24 saatlik eğilimiyle.
- Allocatable'a göre Cluster kullanımı, 24 saat.
- Durumları ve son çıkışlarıyla İlgi bekleyen pod'lar; en sık görülen çıkış koduyla En çok restart; Zaman içinde restart'lar; En çok kaynak kullanan namespace'ler (limitlerine en yakın pod'lar).
- Son 15 dakikanın uyarıları ve bir node şeridi; bir node'a tıklayınca Node'lar ekranında açılır.
- Canlı olaylar tüm cluster için, Uyarılar filtresinde açılır.
Node'lar
Yapmak istediğiniz: hangi node'un dolu, cordon'lu ya da baskı altında olduğunu ve üzerinde neyin çalıştığını
görmek. g n ya da sol menü.
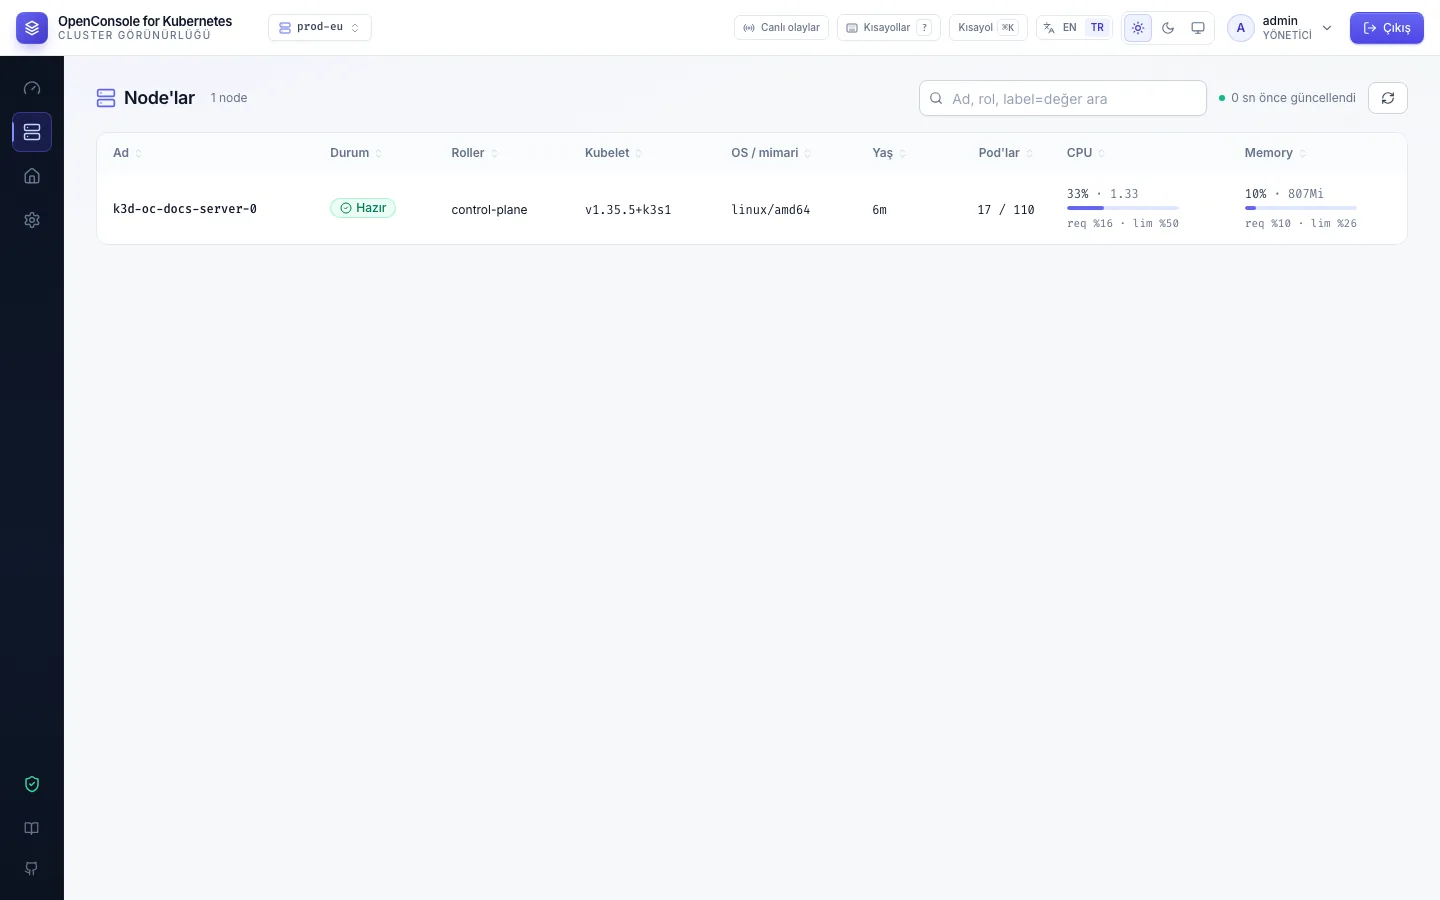
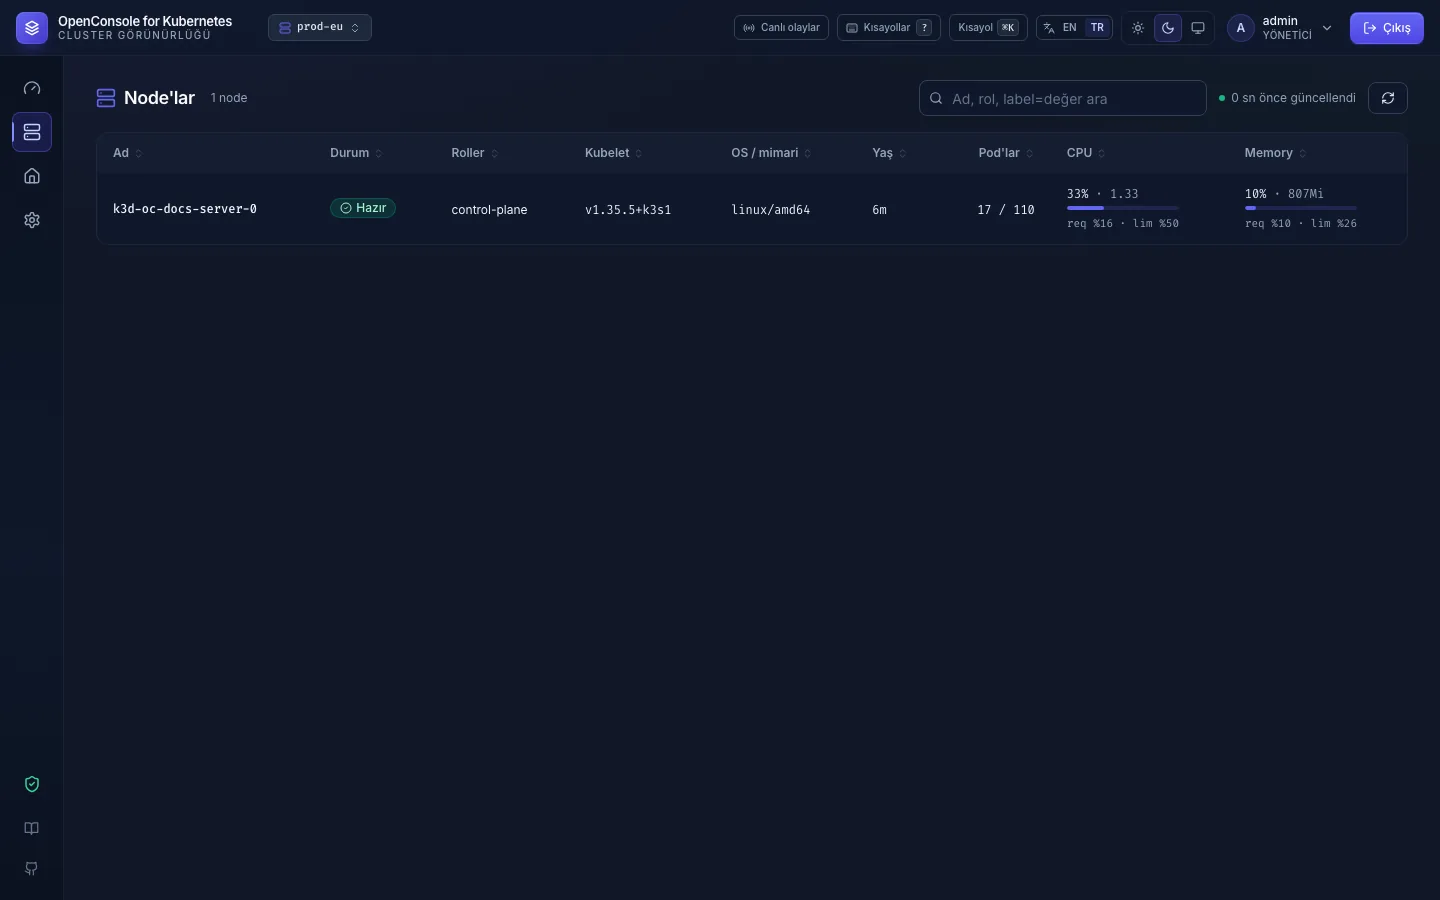
Durum (Hazır / Hazır değil / baskı, cordon), roller, kubelet sürümü, OS / mimari, yaş, kapasiteye göre pod sayısı ve
allocatable'ın yüzdesi olarak kullanılan, request edilen ve limitlenen CPU / memory. Ada, role ya da label'a göre
arayabilirsiniz (key=value). Ayrıntı paneli için bir node'a tıklayın:
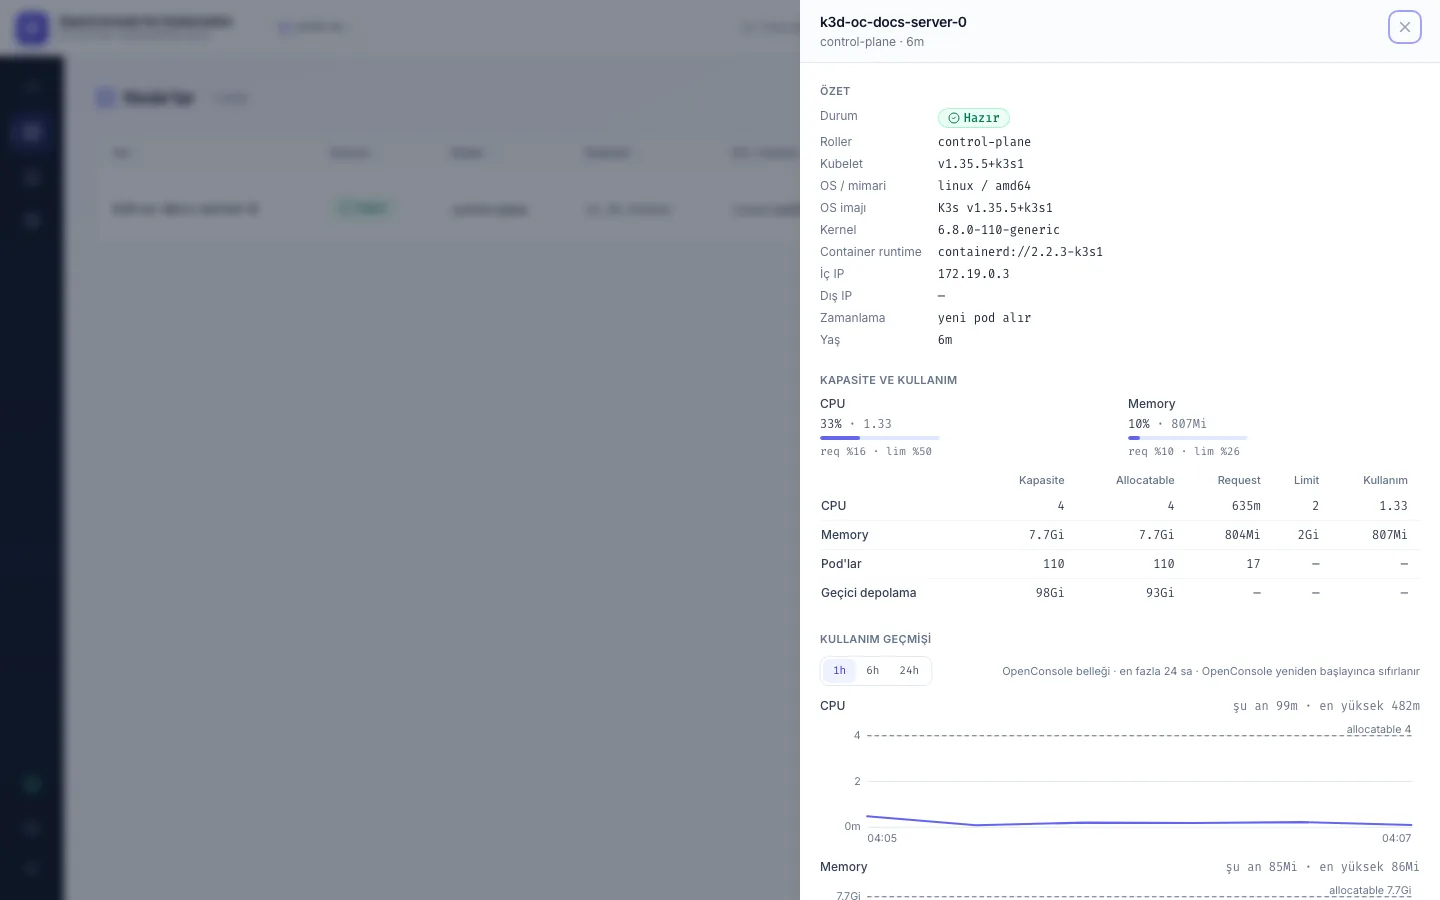
Özet (OS imajı, kernel, runtime, IP'ler, cordon durumu); CPU, memory, pod'lar ve geçici depolama için kapasite / allocatable / request / limit / kullanım; kullanım geçmişi (1 sa / 6 sa / 24 sa, Prometheus ile 7 gün); en çok kaynak kullanan pod'ları, üzerindeki tüm pod'lar, condition'lar, taint'ler, label'lar, annotation'lar ve olaylar.
Sayılar nereden gelir
| Veri | Kaynak | ClusterRole'de gereken |
|---|---|---|
| pod'lar, iş yükleri, olaylar | informer önbelleği | rbac.yaml'ın okuma kuralları |
| node listesi, kapasite, condition'lar | informer önbelleği | nodes: get / list / watch |
| anlık CPU / memory | metrics-server, 30 sn'de bir örneklenir | metrics.k8s.io pods ve nodes: get / list |
| kullanım geçmişi | OpenConsole'un belleği (24 sa, restart'ta sıfırlanır) ya da Prometheus (7 güne kadar) | Prometheus "cluster içinden" modu için: Service'inde services/proxy |
nodes kuralları olmadan Genel bakış yine çalışır: CPU / memory mutlak değerlerle gösterilir, node şeridi olmaz. Node'lar
ekranı ise bağlantının node'ları listeleyemediğini söyler. Genel bakışı açmak audit'e yazılır (cluster.view_overview),
node ekranları da node.list / node.get olarak; ekranların kendi yenilemeleri yazılmaz.