Pod sağlığı
Yapmak istediğiniz: bir pod'un neden çalışmadığını ya da neden sürekli restart ettiğini öğrenmek.
Pod'um neden restart ediyor?
-
Duruma bakın. Pod'lar sekmesi,
kubectl get pods'un yazdığı STATUS'u aynı yolla hesaplayarak gösterir (init container'lar, Terminating ve Unschedulable dahil). Kırmızı, crash ettiğini ya da başlayamadığını gösterir (CrashLoopBackOff,OOMKilled,ImagePullBackOff,Init:Error,Error); sarı bekliyor ya da hazır değil, yeşil hazır, gri tamamlandı demektir. Son uyarı olaylarını görmek için fareyi kırmızı ya da sarı bir durumun üzerine getirin. -
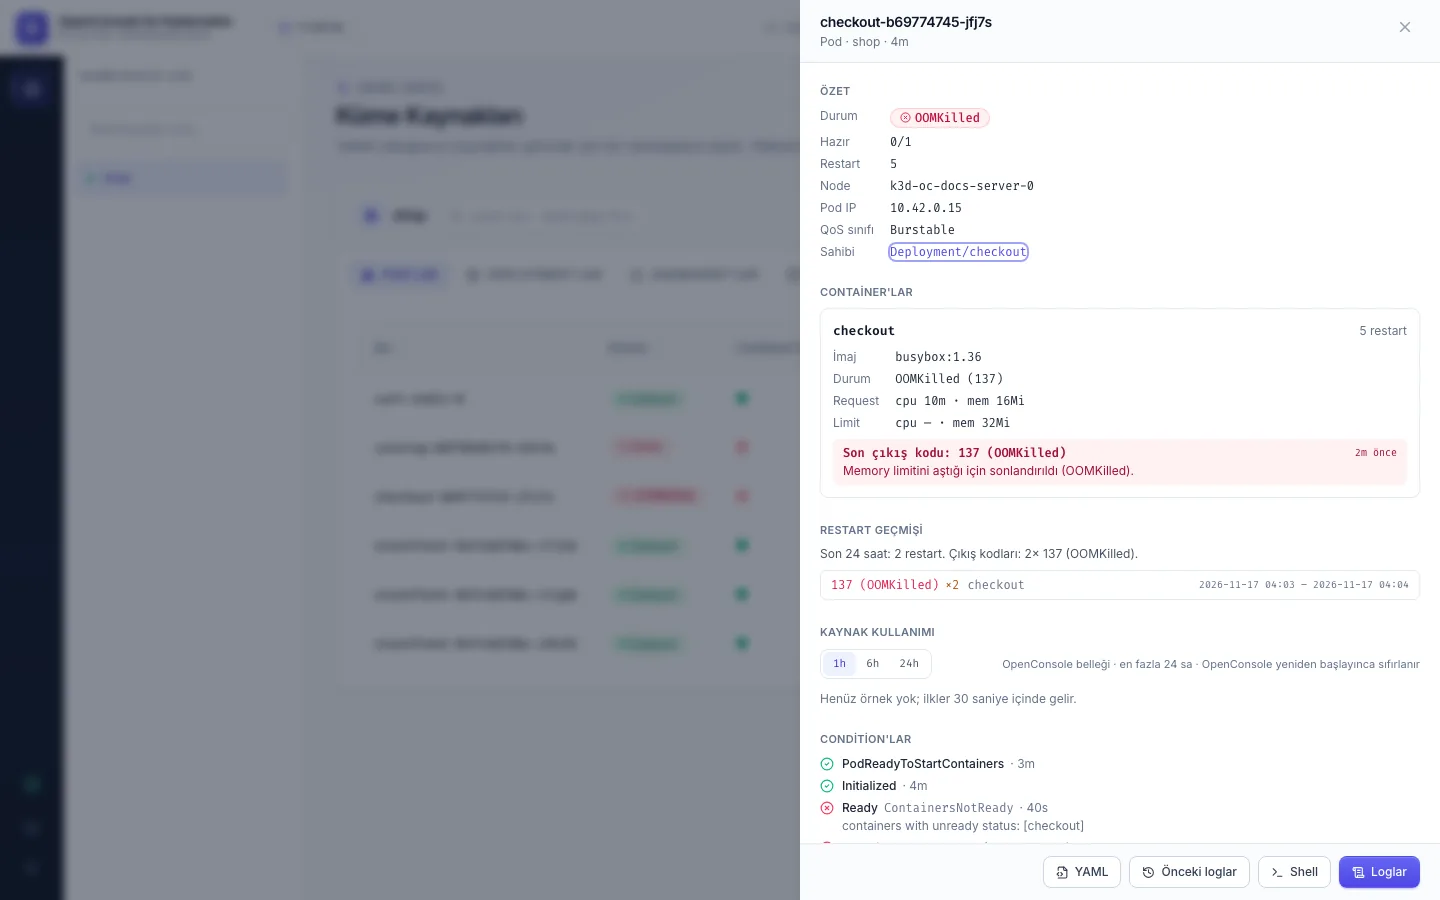
Son çıkışı okuyun. Restart sayısının yanında, restart etmiş bir container'ın son çıkışı yazar, ör.
6 · 137 OOMKilled · 3m. Kodun genelde ne anlama geldiğini aşağıdaki tablo söyler. -
Pod'u açın (satırına tıklayın). Ayrıntı paneli çıkış kodunu açıklar; her container'ın durumunu, request ve limit'lerini, restart geçmişini ve olayları gösterir:
-
Crash'in logunu okuyun. Ayrıntı panelinde Önceki loglar, çıkış yapan container instance'ının, yani hatayı içerenin logunu açar (Loglar).
-
Limit'lerle karşılaştırın. Kaynak kullanımı'ndaki memory çizgisi her restart'tan önce limite dayanıyorsa, limit çok düşüktür ya da program bellek sızdırıyordur.
Çıkış kodları
| Kod | Genelde anlamı |
|---|---|
OOMKilled ile 137 | container memory limitini aştı ve sonlandırıldı |
diğer durumlarda 137 | dışarıdan sonlandırıldı: başarısız bir liveness probe, ya da grace period'dan uzun süren bir durdurma |
143 | normal bir SIGTERM: rollout, ölçek küçültme, node drain |
1 | uygulama hatayla çıktı; önceki logunu okuyun |
126 / 127 | komut çalıştırılamıyor / imajda yok |
0 | iş bitti; ama bir Deployment'ta program durmamalıydı |
Kubernetes her container'ın yalnızca son çıkışını tutar. OpenConsole ise gördüğü her çıkışı 30 gün saklar (Restart geçmişi); artık var olmayan pod'lar için bile. Böylece bir Deployment, yerine yenisini koyduğu pod'ların restart'larını da gösterir. Art arda gelen aynı çıkışlar, sayısıyla birlikte tek satır olur. OpenConsole başlarken karşılaştığı pod'ların hâlâ taşıdığı son çıkışı da kaydeder. OpenConsole'un kendisi kapalıyken olan çıkışlar, pod bunları sonrasında hâlâ göstermiyorsa kaybolur.
Container'lar sütunu
Her container için bir kare; önce pod'un container'ları, sonra init container'ları:
| Kare | Anlamı |
|---|---|
| dolu yeşil | çalışıyor ve hazır (sarı halka: restart etmiş) |
| dolu sarı | çalışıyor ama hazır değil, ya da başlıyor |
| dolu kırmızı | bir hata yüzünden bekliyor (CrashLoopBackOff, ImagePullBackOff, …) |
| içi boş gri | 0 ile çıktı (ör. işi bitmiş bir init container) |
| içi boş kırmızı | hatayla çıktı |
Container'ın adını (init container'lar ve sidecar'lar işaretlidir), durumunu, başlangıç zamanını ve restart sayısını görmek için fareyi bir karenin üzerine getirin. Sütuna göre sıralamak pod'ları container sayısına göre dizer (en çok olan önce); container sayısı aynı olan pod'larda sorunlu container'ı daha çok olan önce gelir. Kartlar, birden fazla container'ı olan pod'lar için aynı kareleri durumun yanında gösterir. Sahibi, pod'un doğrudan controller'ının türüdür (ReplicaSet, StatefulSet, DaemonSet, Job, ya da static pod için Node); adı fareyle üzerine gelince görünür.
CPU ve memory
Cluster'da metrics-server varsa, pod'lar ve iş yükleri kullanımı limite (limit yoksa request'e) göre gösterir: %70'ten itibaren sarı, %90'dan itibaren kırmızı. OpenConsole her pod'u 30 saniyede bir okur ve bellekte son bir saati 30 saniyelik, 24 saate kadarını 5 dakikalık ortalamalarla tutar (OpenConsole yeniden başlayınca sıfırdan başlar). Grafikler bunu kullanır; yöneticiniz cluster'ın Prometheus'unu bağladıysa en fazla 7 günü kapsar. Her grafik verisinin nereden geldiğini yazar.
- CPU / memory yok, ya da "Henüz örnek yok": cluster'da metrics-server yok, ya da OpenConsole bir dakikadan kısa süre önce başladı.
- Önceki log yok: bazı container runtime'ları, bir saniye içinde ölen container'ın logunu tutmaz. Bu durumda
Kubernetes'in döndüreceği bir şey yoktur;
kubectl logs --previousile aynı. - Pod'u açamıyorsunuz:
pods:getizni gerekir; loglar içinpods:logs.